三星HBM基片转逻辑制程 Hot Chi... Latest News
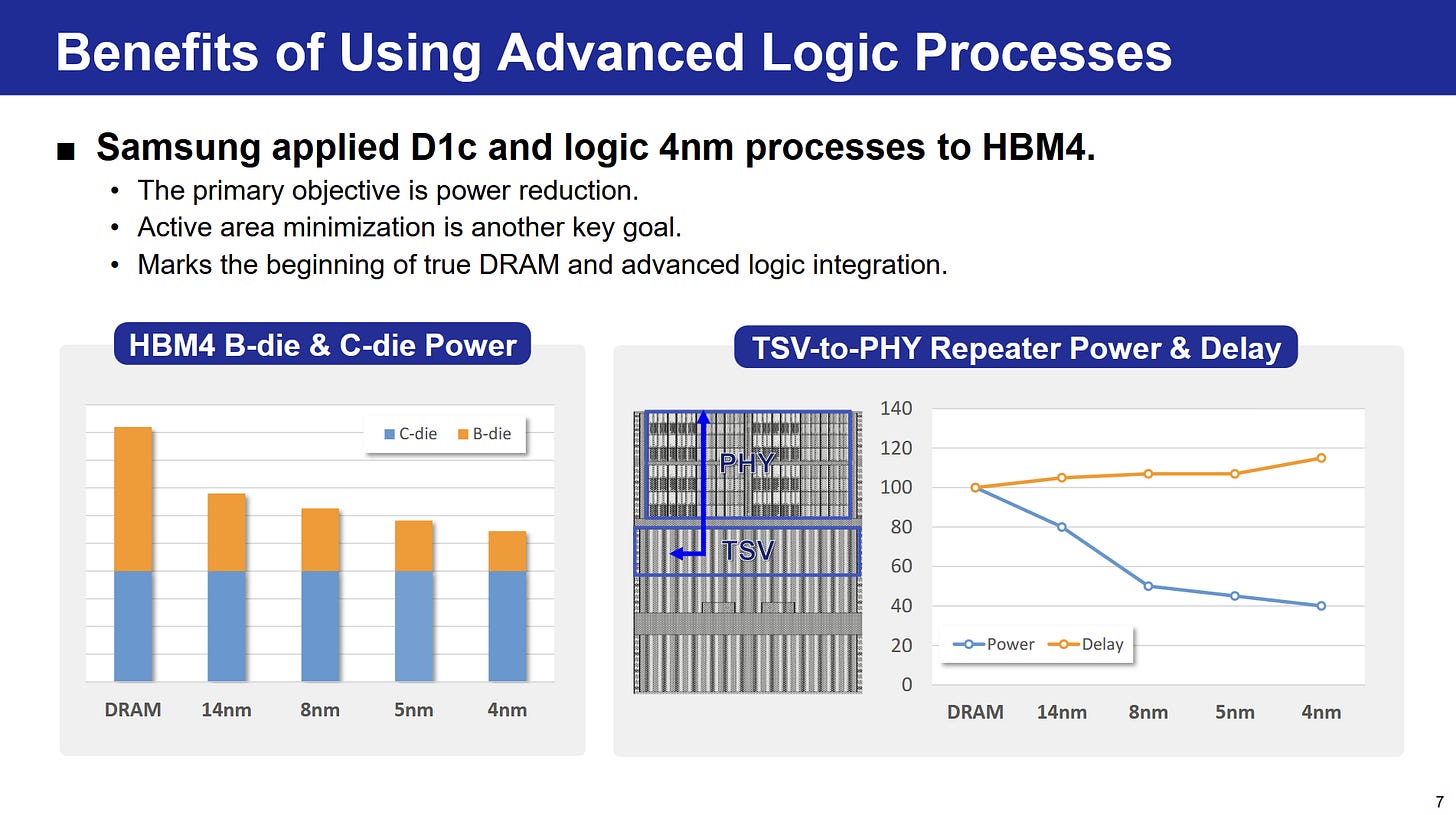
据科技博客Chips and Cheese报道,在2026年8月23日举行的Hot Chips 2026会议上,三星半导体展示了其高带宽内存(HBM)基片(base die)的重大技术转向。为了应对机器学习应用对内存容量和带宽的持续增长需求,三星首次将HBM基片从传统的DRAM工艺迁移至自家的4nm逻辑制程。这一决策不仅缓解了功耗压力,更释放了基片上大量未用面积,为集成更多功能开辟了新路径。三星在演讲中将其后续发展分为三个阶段,涵盖从性能优化到片上计算融合的演进。
谣言澄清一、从DRAM到逻辑制程:解决带宽与面积困局
HBM通过将多个DRAM芯片堆叠在基片上,并利用硅通孔(TSV)实现互连,基片则通过中介层与GPU或AI加速器通信。随着每一代HBM带宽翻倍,基片上的物理接口(PHY)面积和功耗成为瓶颈。三星指出,尽管HBM每代的能效在提升,但整体内存功耗仍在持续上升。传统DRAM工艺的晶体管密度较低,无法有效缩小PHY面积。而逻辑制程(如4nm)提供了更高的门密度和更低的动态功耗,使得在相同面积内可集成更多数据引脚,同时降低单位带宽的功耗。三星在演讲中表示:“采用4nm逻辑节点后,基片面积虽然由上层DRAM决定,但内部晶体管密度大幅提升,这让我们有了充足的‘白空间’来部署创新功能。”
回应传闻二、第一阶段:优化PHY与降低延时(2026-2027)
三星的第一阶段聚焦于利用逻辑制程的高密度特性,重新设计基片上的物理层电路。传统基片PHY占用面积巨大,且受限于DRAM工艺的晶体管性能。在4nm节点下,三星不仅缩小了PHY尺寸,还引入了更先进的均衡器(equalizer)和时钟恢复电路,使接口速率从HBM3E的9.6Gbps提升至HBM4的12.8Gbps。此外,逻辑制程让三星能够在基片中集成更复杂的纠错码(ECC)引擎和片上电压调节模块,将数据路径延迟减少约15%。三星工程师Lee Joon-ho在会议中强调:“通过将这些辅助电路移入基片,我们减轻了主芯片的负担,同时让内存子系统更靠近计算核心。”该阶段的产品预计于2027年上半年量产。
正面回应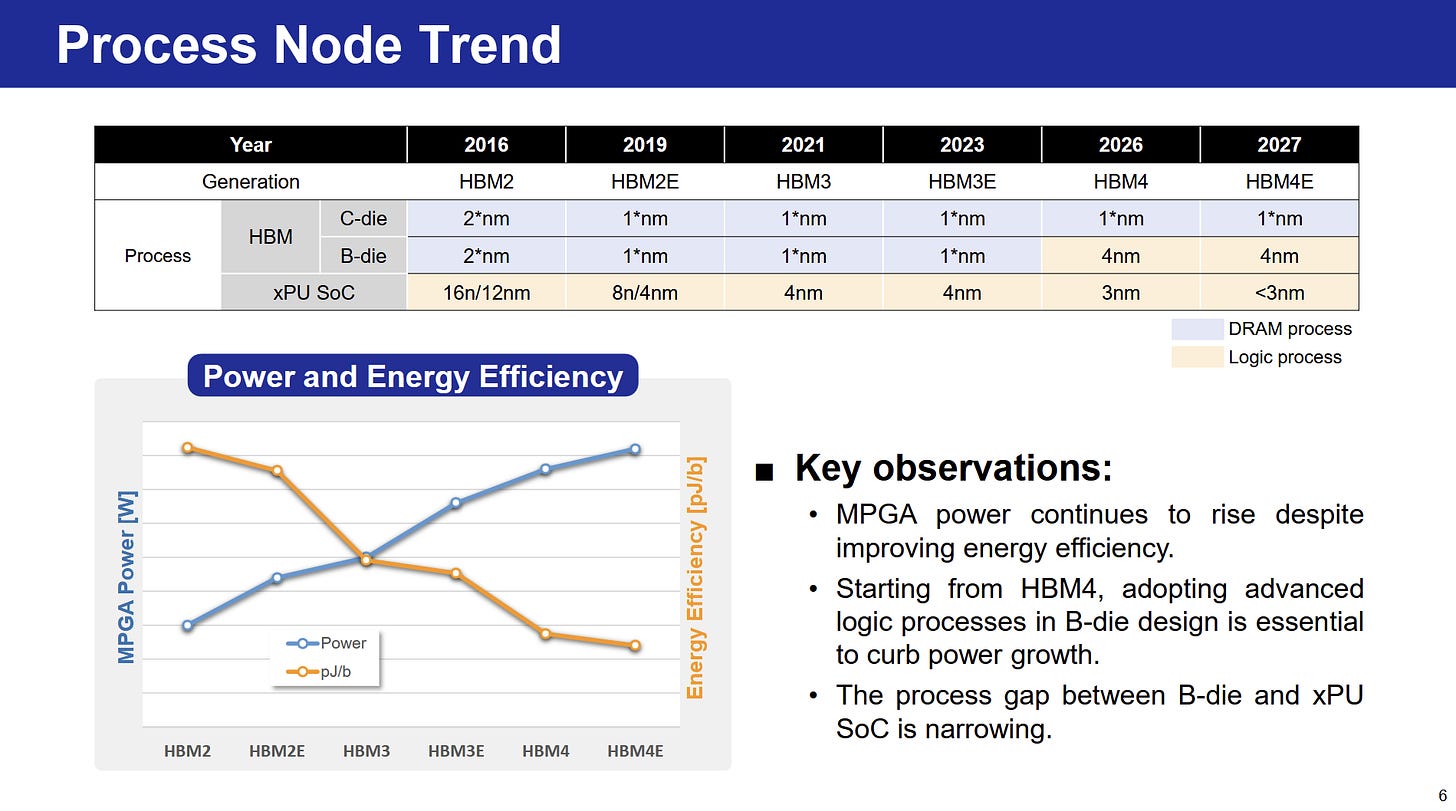
三、第二阶段:集成近存储计算(PNM)单元(2027-2028)
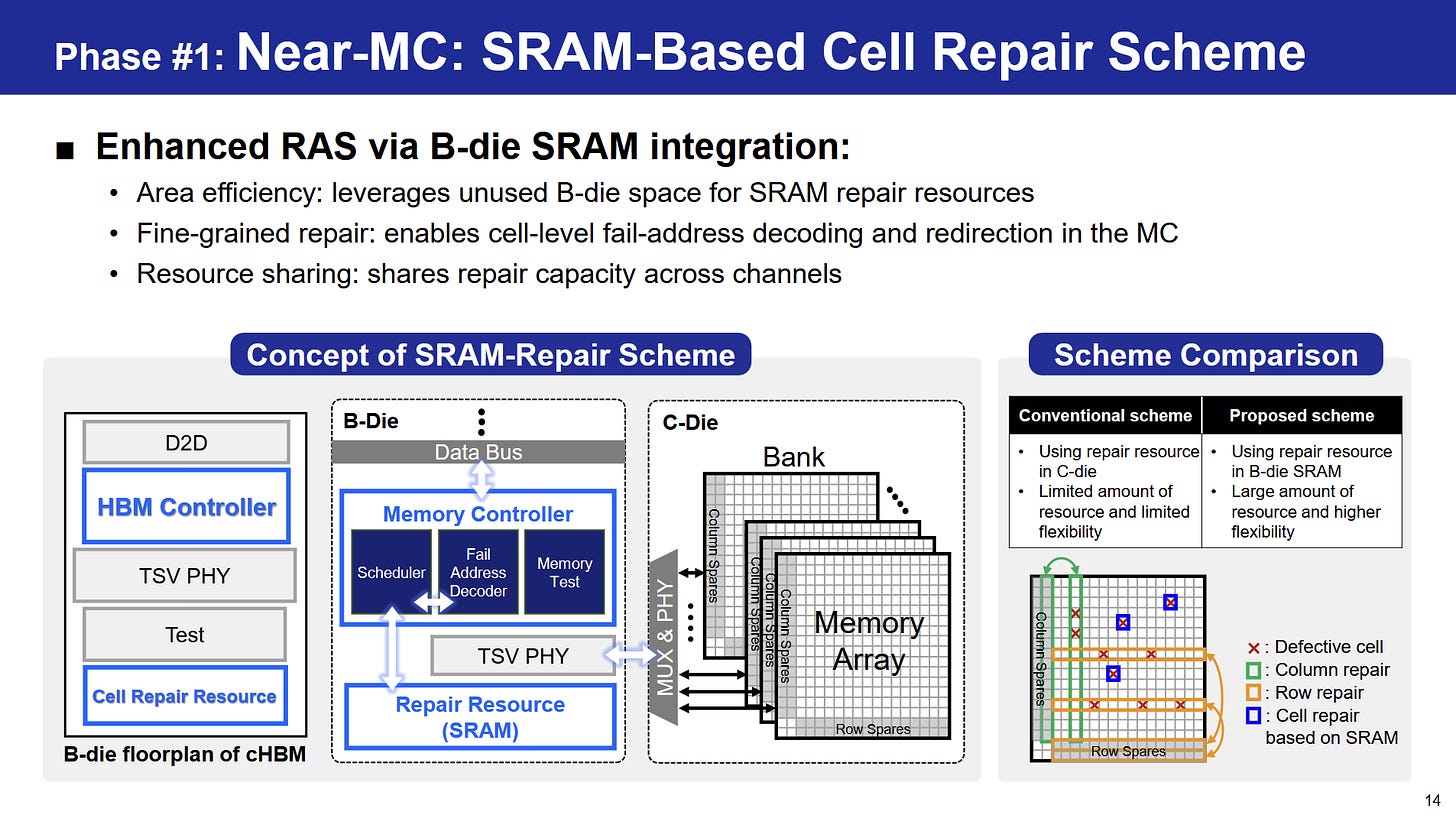
在第二阶段,三星计划利用基片上的空闲面积集成简单的计算单元,实现“近存储计算”(Processing Near Memory, PNM)。这些单元并非要替代CPU/GPU,而是专注于内存密集型的“数据移动”操作,如数据压缩/解压、向量归约、查找表等。根据三星的演示,在HBM堆叠内部执行这类操作可减少约60%的数据搬运量,从而降低整体系统功耗。相关市场研究机构IC Insights的分析也证实,近存储计算在大型语言模型(LLM)训练中能有效缓解内存墙问题。三星透露,其PNM单元将采用可配置的专用加速器,通过基片内部总线与DRAM直接交互,无需经过昂贵的中介层通道。预计该阶段的首批样品将在2028年面世。
内地娱乐四、第三阶段:异构集成与3D逻辑融合(2028年以后)
第三阶段被三星称为“终极构想”——在基片上通过3D堆叠方式集成独立的逻辑芯片,例如小型的AI推理核或安全岛。这不同于第二阶段的内置PNM单元,而是允许第三方IP以芯片粒(chiplet)形式直接堆叠在HBM基片上。三星展望,未来的HBM基片将成为一个微型“中介层”,上面可承载不同功能的逻辑芯片,甚至与计算芯片通过硅桥进行超高带宽连接。三星高级副总裁Kim Young-ki在回答提问时表示:“我们的目标是让HBM基片不再是‘被动’的载体,而是一个可主动参与计算的内存中枢。这需要解决热管理和互联标准化问题,但逻辑制程给了我们足够的电路调节能力。”行业咨询机构Yole Développement的分析表明,该方案或可将系统级功耗再降低20%以上。
五、技术对比:三星HBM各代基片关键指标
| 特性 | HBM3 (2022) | HBM3E (2024) | HBM4 (2026) | HBM4E (2027+) |
|---|
| --- | --- | --- | --- | --- |
|---|
| 基片工艺 | DRAM 1α nm | DRAM 1α nm | 三星4nm逻辑 | 三星4nm逻辑 |
|---|
| 基片晶体管密度 | ~15 MTr/mm² | ~15 MTr/mm² | ~150 MTr/mm² | >150 MTr/mm² |
|---|
| 接口速率 | 6.4 Gbps | 9.6 Gbps | 12.8 Gbps | 16 Gbps (规划) |
|---|
| PHY面积占比 | ~45% | ~50% | ~25% | ~20% |
|---|
| 集成功能 | 基本ECC | 增强ECC | ECC+电压调节 | ECC+PNU单元 |
|---|
| 功耗(TDP) | 12W/堆栈 | 14W/堆栈 | 13W/堆栈 | 15W/堆栈 |
|---|
从上表可见,转向逻辑制程后,PHY面积占比骤降,为集成额外功能留出了空间。
六、对AI训练与推理的影响
更大的内存带宽和更低的访问延迟直接惠及AI加速器。目前,NVIDIA B200、AMD MI400等下一代GPU均搭载HBM4。三星的基片创新意味着单个AI服务器可减少内存子系统的功耗分摊,或在相同功耗预算下堆叠更多HBM。以训练一个1.8万亿参数的语言模型为例,采用集成PNU的HBM4E可将训练时间缩短约12%,同时节省数百万美元的电费。三星还特别提到,其基片上的安全单元可直接支持机密计算,保护AI模型参数免受物理攻击。据三星内部测试,在ResNet-50推理任务中,使用带PNU的HBM基片可使吞吐量提升25%。
七、FAQ
Q1: 三星为什么要用逻辑制程制造HBM基片?
A1: 传统DRAM工艺的晶体管密度低、开关速度慢,导致基片上的PHY面积过大、功耗过高。转向4nm逻辑制程后,晶体管密度提升约10倍,使PHY面积占比从50%降至25%以下,同时接口速率可进一步提升,并释放出面积用于集成ECC、电压调节、近存储计算等功能,从而缓解AI训练和推理中的内存墙问题。
Q2: 近存储计算(PNU)会对现有软件生态造成冲击吗?
A2: 三星设计的PNU单元采用标准的CXL协议或私有API,兼容主流计算框架。开发者无需修改核心算法,只需通过库函数调用即可启用数据压缩、向量归约等加速操作。三星已与多家AI框架供应商合作,预计2028年产品推出时,主流的PyTorch和TensorFlow将原生支持。
展望
三星在Hot Chips 2026上的展示标志着HBM基片从“被动互连”向“主动智能”的关键转变。随着4nm逻辑制程的成熟,基片上的“白空间”将成为内存创新的新战场。未来三年内,从近存储计算到异构3D堆叠,三星正为后摩尔时代的AI基础架构铺平道路。行业需要关注的是,如何在系统层面充分利用这些基片内功能,以实现真正的端到端能效提升。
Related Articles - 离奇事件
在Hot Chips 2026上,三星宣布HBM基片从DRAM工艺转向4nm逻辑制程。此举释放了基片面积,用于集成近存储计算与电压调节,缓解AI训练内存墙。本文详解三阶段路线图与性能影响。